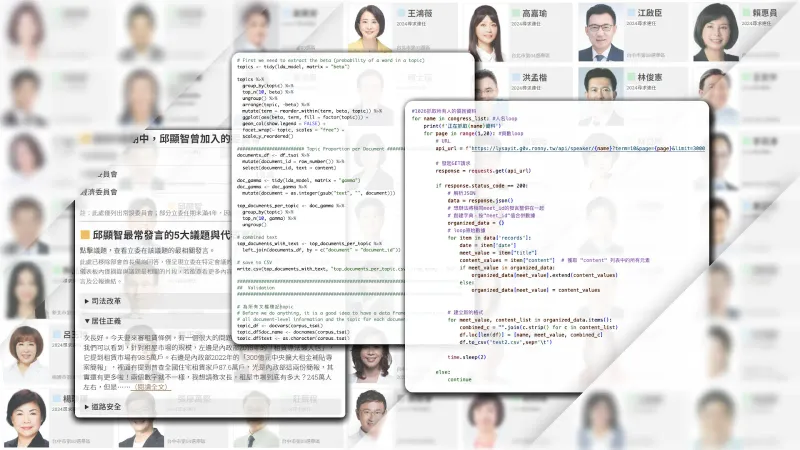
建置定期更新的立委發言觀測儀表板與政治時事資料集
國會的運作效率與關注重點,對國家整體的發展至關重要。長久以來,「立法院究竟在吵什麼」一直是媒體與公民關注的焦點,許多國會監督團體會以出席率、質詢率等數據評估立委表現,但鮮少有報導能夠綜觀立委的所有發言與行動,為民眾提供特定黨團或立委完整的質化分析。 2024選前,非營利媒體《報導者》蒐集四年來所有立委發言,建立貼近台灣社會脈動的資料集,以機器學習方式建置政治語言模型,深入分析各黨團、立委的關注焦點,讓選民以更低門檻觀察立委發言品質。 本計畫希望在此基礎之上,結合AI技術與資深國會記者的專業,建置完整、定期更新、符合當代台灣政治時事脈絡的語言模型及資料集,並公開模型與資料集,推進國會相關應用與研究。同時開發出可定期更新的立委發言儀表板,選民在每個會期都能透過儀表板,觀察特定黨團與立委的關注重點,從而監督國會運作,促進國會效率與民主制度的健全發展。
02. 提案代表人
03. 提案代表人的 g0v Slack 帳號名稱與成員識別碼
06. 專案於 g0v slack 的頻道名稱
07. 提案團隊簡介及與主題的相關性
本專案由《報導者》團隊與歐噴公司合作開發,前者曾在2024選舉前以機器學習方式分析立委發言,抓取其發言重點;後者長期致力於國會資料開放,將立院資料結構化,並製作API供民間技術人員協作使用。
- 專案經理、模型開發:《報導者》數據記者簡毅慧
- 資料工程師、自動化流程開發:歐噴公司創辦人Ronny Wang
- 網頁設計師:《報導者》設計師
- 前端工程師:《報導者》工程師
- 後端工程師:歐噴公司工程師Tmonk
- 監製:《報導者》創辦人何榮幸、總編輯方德琳、Data小組召集人柯皓翔
09. 專案符合本次計畫哪些主題:(請勾選至少一項)
繁體中文文本採集,用於語言模型訓練資料
繁體中文為主的開源模型
10. 參與梯次
12. 專案摘要(300字以內)
13. 專案動機
長久以來,台灣立法院議事品質的分析多為一次性且停留在表面,缺乏深度和系統性。《報導者》專題儘管提供了深入分析,卻受限於數據獲取與更新的困難。現有的數據與語言模型忽視了本土的獨特性及時事的變動性,使相關研究與分析變得極為困難。立法院公報雖公開發言記錄,但資料的清洗與收集工作繁瑣,未經系統化處理,大大增加了政治學者、國會工作人員和選民深入理解議會動態的難度。
此專案意在透過當代AI與機器學習技術改善此情況,提供一個定期更新、易於獲取與分析的立委發言資料集,支援台灣政治相關的語言模型開發與應用,進一步促進公眾對政治透明度的理解和參與。
14. 專案設計概念以及與主題的相符性
- 定期搜集發言資料:建置API定期從立法院公報抓取立委發言紀錄,並依人物、會期、委員會分類,確保資料結構清晰、易於使用。
- 本土政治語料集更新:結合專業記者、NLP與機器學習模型訓練,提高模型對台灣政治語境的辨識與理解能力。
- 資料處理與分析:進行資料清洗、斷詞等預處理步驟,並以LDA模型分析政治話題的主題趨勢。
- 專業審核與更新:借重資深國會記者的專業知識進行內容審核,確保機器分析結果的品質與準確度。
- 建立互動式儀表板:透過使用者訪談,建置使用者友善的儀表板,展示發言分析結果 全流程自動化:整合以上流程,從數據蒐集到成果展示全自動化,有效降低後續維運成本,確保專案持續運行與更新。
15. 專案技術可行性
- 我們將採用中研院開發的CKIP Tagger斷詞系統為基底,並匯入過去已搜集整理到一定程度的政治專用詞清單(立院熱門議題、法條、常見人物姓名),將資料預處理全流程自動化。(詞彙清單可參考Github)
- 資料預處理完畢後,我們預計使用LDA主題模型,分析文件中詞彙的共現關係,觀察出文件中的潛在主題結構。(主題分類可參考Github)
- 若本專案獲得計畫資源,我們希望與專家討論,確認是否能透過建立Transformers深度學習模型(如BERT、GPT-3),對收集到的政治發言數據進行語義理解和情感分析,理解文本的深層意義及情緒傾向,將LDA辨識出的廣泛主題做更細緻的分類,挖掘立委更具體的議題與立場。
16. 專案可應用之情境說明
- 對台灣選民:
對無政治研究背景的選民而言,本專案提供的政治語言分析工具,能夠幫助他們快速理解國會的工作進程與表現,選民可以查詢他們感興趣的議題或立委,了解特定立委對各大議題的態度與行動,增強公民對政治過程的關注及參與度。
- 對媒體、國會助理、利益團體與學者:
提供政治議題分析工具,讓媒體記者、國會助理、利益團體與學者能在no-code或low-code的背景下,每會期仍能監測、分析特定議題在立院的討論情況。
17. 專案預期效益與社會貢獻
透過AI技術分析國會政治語言、建置專屬台灣政治語境的模型,我們希望這個專案能夠促進台灣的政治透明度、增強公民參與、提升政治報導與國會研究的品質。
- 提高政治透明度
我們將大量的立委發言逐字稿,收斂成一般讀者好理解且能有效歸納重點的形式,讓選民和社會各界能夠更直觀地了解立法院的工作情況、議題討論的內容以及立委的表現,以增進立院活動的能見度及公眾的理解程度。
- 促進公民參與
我們提供易於操作與理解的政治分析工具,鼓勵更多的公民參與政治討論和決策過程。選民能夠基於具體數據和分析結果對政治議題建構自己的政治見解,進一步提高公共事務討論的廣度與深度,健全民主政治發展。
- 促進國會相關的研究
我們注意到近年來,有越來越多的博碩士生以立院發言資料為基礎進行語義分析,本專案可成為國會相關學術研究的基礎資源與實證數據,讓更多無程式背景的政治學者在教學、學習和研究中使用,促進政治學、社會學和語言學等領域的研究。
18. 專案現況說明
19. 團隊過去是否有做過相關主題的計畫?
20. 開源內容及其授權方式
- 程式碼公開至 GitHub,Apache 2.0 License
- 資料集與模型公開至Hugging Face,Apache 2.0 License
21. 專案期中與期末規劃
期中(2024年6月初):
- 資料預處理:確保公報資料穩定匯入,確認斷詞資料集清單
- 初步模型評估:與專家討論、測試出合適的語言模型,進行技術驗證
- LDA主題模型研究
- 深度學習模型可行性探討
- 完成使用者訪談,包含記者、國會助理、選民等
- 完成後台操作流程設計,確保後續自動化流程便於管理、維護
- 完成儀表板網頁架構,確保使用者友善、滿足功能需求
期末(2024年8月初):
- 模型微調
- 建立人工審核流程,控制結果的精準度、政治風險與敏感度
- 全流程自動化、資料流串接
- 完成前後端介面設計、測試與調整
22. 專案預算規劃
| 項目 | 說明 | 預估價格 |
|---|---|---|
| 模型開發與維運 | 定期購買相關應用程式(包含但不限於BERT、GPT) | 150,000 |
| 立院API建置、資料清理 | 自動化蒐集、彙整立法院公報中的發言紀錄 | 100,000 |
| 資料庫伺服器維運 | 根據雲服務提供商定價 | 50,000 |
| 人事費用 | 前端工程師1位 後端工程師2位 網頁設計師1位 模型開發人員1位 |
200,000 |
23. 專案於計畫結束後之長期規劃
- 持續優化語言模型與儀表板
本專案屬長期計畫,技術上,我們會持續更新、優化繁體中文政治語言模型,反應最新的政治現場、議題趨勢與社會脈動。儀表版也會定期更新,讓選民、記者及國會工作人員都能夠持續使用。 - 教育及學術研究推廣
我們認為這個專案能夠有效促進國會監督與民主發展,值得被推廣到各層級校園與學術研究機構,除了提升政策討論的透明度與效率,鼓勵公民參與公共事務討論外,也能提昇公眾對於人工智慧、語言模型應用的認識與理解,讓本土語言模型的重要性更被看見。
成果開源後,各國學術和研究機構也能一同使用,共同推進台灣國會政治研究發展,以及繁體中文語言模型的研究。